Catálogo
O Que É GPT-Live-1? O Modelo de Voz Full-Duplex da OpenAI Explicado
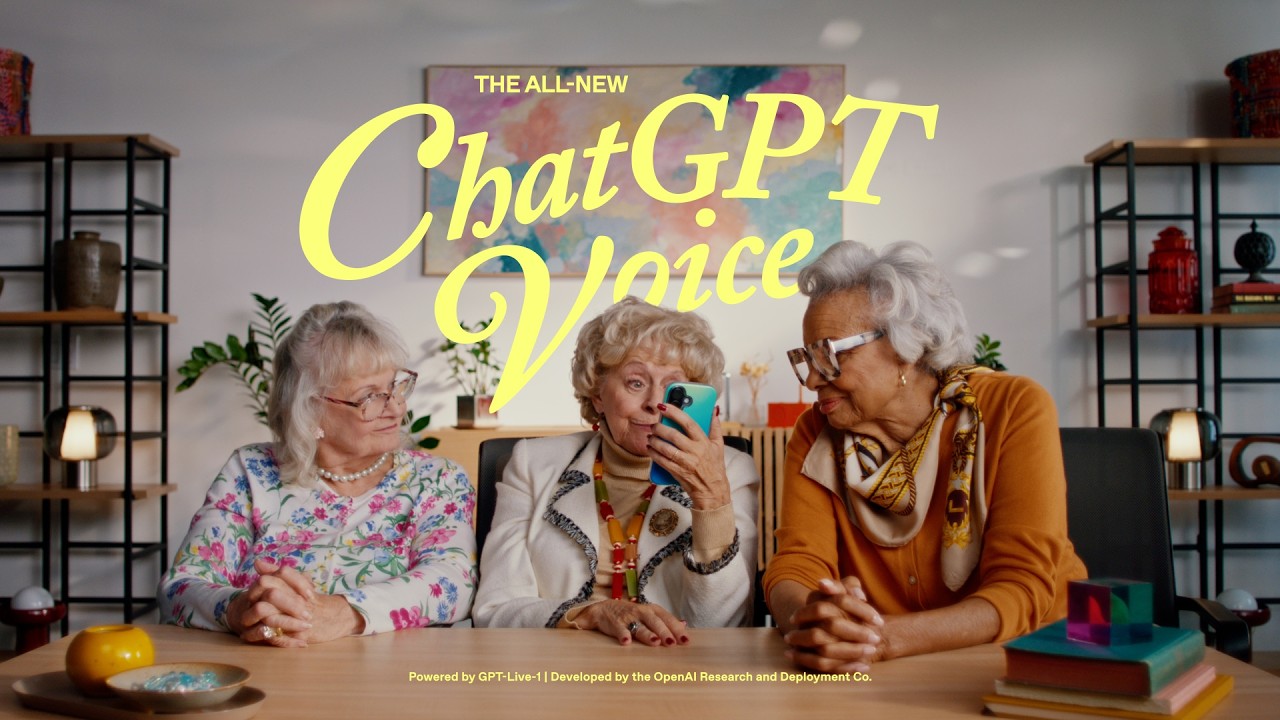
Se você já conversou com um assistente de voz e sentiu que estava usando um walkie-talkie em vez de ter uma conversa, GPT-Live-1 é a solução. É o modelo de voz full-duplex da OpenAI, o que significa que pode ouvir e falar ao mesmo tempo. Chega de esperar a IA terminar antes de poder intervir. Chega de pausas desconfortáveis quando você para para pensar e o assistente assume que você terminou de falar.
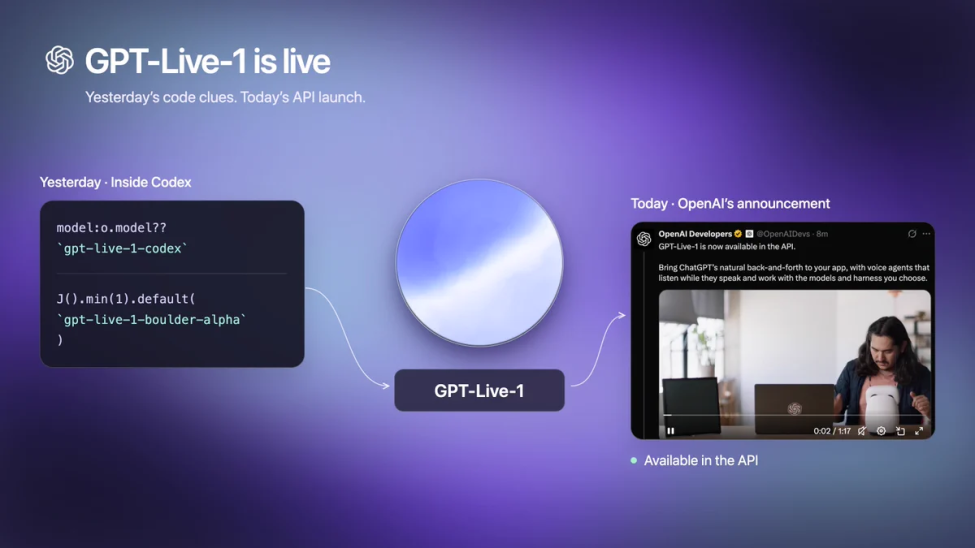
A OpenAI lançou GPT-Live-1 para usuários do ChatGPT em julho de 2026 e abriu para desenvolvedores como API em 10 de setembro. A 0,05 dólares por minuto para a camada frontal de voz, é voltado para desenvolvedores que constroem aplicações de IA de voz em tempo real. O aplicativo do ChatGPT traz essa tecnologia para o seu telefone e você pode experimentá-la agora mesmo.
O que o GPT-Live-1 faz
GPT-Live-1 é um modelo de voz para voz. Parece simples, mas é uma mudança significativa. Os assistentes de voz anteriores encadeavam três modelos separados: voz para texto, um modelo de linguagem para raciocínio e texto para voz. Cada transferência adicionava latência e criava oportunidades de perda de informação.
GPT-Live-1 colapsa essa cadeia. Ele lida com compreensão de voz e geração de voz em um único modelo, o que reduz o atraso entre você falar e a IA responder. Quando a OpenAI o testou contra o anterior GPT-Realtime-2.1 no Full Duplex Bench, GPT-Live-1 obteve 80,1 por cento. O modelo anterior conseguiu 45,4 por cento. Essa é uma diferença de 30 pontos.
O modelo também suporta transcrição ASR nativa e texto de resposta. Os desenvolvedores obtêm o áudio e a versão em texto sem adicionar um serviço de reconhecimento de voz separado.
Como funciona a IA de voz full-duplex
Full-duplex é um termo de telecomunicações. Significa que os dados fluem em ambas as direções ao mesmo tempo. Aplicado à IA de voz, o modelo processa seu áudio de entrada enquanto simultaneamente gera sua própria saída de voz. Ele não espera silêncio para decidir que você terminou de falar.
Em vez disso, GPT-Live-1 toma decisões múltiplas vezes por segundo: deve falar, continuar ouvindo, pausar, interromper ou chamar uma ferramenta? Você pode interromper no meio de uma frase e o modelo se ajusta. Se você faz uma pausa para pensar, ele espera. Até lança um breve "mhm" ou "certo" para sinalizar que continua ouvindo, como humanos fazem em uma conversa real.
Isso representa uma mudança em relação a sistemas baseados em turnos como o antigo Advanced Voice Mode do ChatGPT, que dependia de detecção de silêncio para determinar quando você terminava de falar. Uma sirene distante ou uma pausa de um segundo podia enganá-lo e fazê-lo responder cedo demais.
Delegação backend para GPT-6 Astra e outros modelos
GPT-Live-1 lida com a camada de conversa. Não se encarrega de cada tarefa. Quando uma pergunta precisa de raciocínio profundo, busca na web ou chamadas de ferramentas, o modelo delega esse trabalho a um modelo backend de texto. No lançamento, o modelo backend inicial era GPT-5.5. Os desenvolvedores agora podem configurar qual modelo backend usar, incluindo GPT-6 Astra.
Essa separação importa porque distingue a interação de voz da profundidade de raciocínio. Você obtém conversa natural e de baixa latência na frente e o poder computacional de que precisar no backend. Os desenvolvedores escolhem o nível de raciocínio que se encaixe no seu caso de uso e orçamento.
O benchmark Tau3 da OpenAI, que testa tarefas de agentes de voz de ponta a ponta, classificou GPT-Live-1 emparelhado com GPT-6 Astra em intensidade de raciocínio média como número um. Não é um número de laboratório. É um benchmark competitivo contra outros sistemas de agentes de voz.
Desempenho no mundo real e primeiros adotantes
Duas empresas compartilharam resultados de acesso antecipado. Speak, um aplicativo de aprendizado de idiomas, relatou que interrupções falsas durante pausas de pensamento dos estudantes diminuíram quase 80 por cento comparado ao seu sistema anterior baseado em turnos. Isso é uma melhoria direta na experiência do usuário. Estudantes que fazem uma pausa para lembrar uma palavra não são mais interrompidos por uma IA impaciente demais.
Tony Stoyanov, CTO de uma plataforma de serviços médicos, disse que sua equipe reduziu sua base de código em 80 por cento. Eles eliminaram aproximadamente 23.000 linhas de código de cola que anteriormente gerenciavam detecção de turnos, tratamento de interrupções e sincronização de estado. GPT-Live-1 lida com essas questões nativamente.
O Yelp está usando GPT-Live-1 para reservas de restaurantes por telefone. Seu CTO Alex Levy relatou melhor atendimento de chamadas, mas nenhuma métrica específica foi compartilhada.
Outros números de benchmark que valem menção: a latência de mudança de turno caiu de 1,4 segundos para 0,8 segundos. A precisão em chamadas de ferramentas subiu de 60 por cento para 87 por cento. Em um benchmark de suporte de voz bancária, GPT-Live-1 aprovou 32 por cento das interações, contra 12,4 por cento do modelo anterior. Esse número bancário ainda é baixo em termos absolutos, mas mostra a direção.
Preços e acesso para desenvolvedores
A camada frontal de voz custa 0,05 dólares por minuto. Isso equivale a cerca de 3 dólares por hora. Os custos do modelo backend e das ferramentas de agente são cobrados separadamente, então sua despesa total depende de qual modelo de raciocínio você escolhe e quantas chamadas de ferramentas faz.
Para uma interação de voz de dez minutos, você está olhando para 0,50 dólares apenas em custos da camada de voz. Se isso é caro depende do seu caso de uso. Uma central de atendimento que lida com milhares de chamadas diárias sentirá o custo. Um aplicativo de aprendizado de idiomas onde cada sessão dura alguns minutos pode achar razoável.
Os desenvolvedores podem configurar o modelo através de prompts do sistema. Você pode ajustar o tom, a velocidade da fala e o estilo de conversa. Também pode conectar ferramentas, frameworks de agentes e modelos backend através da API. A OpenAI também adicionou doze vozes novas que abrangem diferentes sotaques, dialetos e idiomas: Quartz, Ripple, Vesper, Willow, Stone, Gleam, Meridian, Bossa, Tempo, Beacon, Delta e Cinder. Mais vozes e suporte a idiomas estão planejados para os próximos meses.
A implantação telefônica é suportada. Isso significa que GPT-Live-1 pode lidar com chamadas recebidas e efetuadas para coisas como reservas de restaurantes, atendimento ao cliente e agendamento de consultas.
Vantagens e limitações
As vantagens são claras. A conversa full-duplex parece natural. O tratamento de interrupções funciona. A latência caiu para 0,8 segundos. A precisão de chamadas de ferramentas de 87 por cento significa que o modelo pode executar ações de forma confiável durante uma conversa, como verificar disponibilidade ou reservar um horário. A experiência de desenvolvimento é mais simples, com equipes eliminando dezenas de milhares de linhas de código de orquestração.
As limitações também são reais. A 0,05 dólares por minuto, centrais de chamadas de alto volume acumularão custos rapidamente. A taxa de aprovação de 32 por cento em benchmarks de suporte de voz bancária mostra que interações financeiras complexas e de alto risco ainda estão além do que o modelo pode lidar de forma confiável. Os primeiros usuários do ChatGPT reclamaram que as respostas de respaldo do modelo ("mhm", "sim") eram excessivas, e o TechCrunch notou que demonstrações de tradução de hindi tinham sotaque americano perceptível. A OpenAI não publicou uma lista completa de idiomas suportados, dizendo apenas que "otimizou para os idiomas mais usados".
Como GPT-Live-1 se compara à IA de voz anterior
A tecnologia de voz do ChatGPT passou por três gerações. O Standard Voice Mode original usava uma arquitetura em cascada: voz para texto, depois um modelo de linguagem, depois texto para voz. Funcionava, mas parecia lento e robótico.
O Advanced Voice Mode, lançado com o GPT-4o em 2024, processava o áudio em um único modelo, o que reduziu a latência. Mas ainda era baseado em turnos. O modelo esperava que você terminasse de falar antes de responder. Se você fizesse uma pausa de um segundo, ele podia intervir. Se houvesse ruído de fundo, podia se confundir.
GPT-Live-1 é diferente. Ele está sempre ouvindo enquanto fala. Processa áudio em ambas as direções continuamente. A arquitetura também separa a camada de interação de voz da camada de raciocínio, o que significa que a OpenAI pode integrar novos modelos backend sem retreinar o modelo de voz.
Conclusão
A tecnologia não é perfeita. Tarefas complexas de domínios específicos ainda a confundem. O custo se acumula em escala. Mas pela primeira vez, falar com uma IA parece menos como operar uma máquina e mais como ter uma conversa. Essa é a mudança real aqui.
Se você quer experimentar GPT-Live-1 no seu telefone, faça o download do aplicativo do ChatGPT (disponível para download em Android) e abra uma conversa de voz. Assinantes pagos obtêm GPT-Live-1 por padrão; usuários gratuitos obtêm GPT-Live-1 mini. Abra Configurações, toque em Voz e verifique qual modelo aparece. Uma etiqueta "Live" significa que o novo modelo está ativo. Como com qualquer ferramenta de IA, lembre-se de que as conversas de voz são processadas nos servidores da OpenAI. Revise as configurações de privacy no aplicativo para controlar se suas conversas são salvas para melhoria do modelo, e sempre preste atenção ao que você compartilha durante uma sessão de voz. O veredicto final: a IA de voz finalmente parece falar com alguém, não com algo.
Back to top
 NEWS
 REVIEWS
 HOWTO